Négy hiba, amitől egy prediktív modell sokkal jobbnak látszik, mint amilyen. Tiszta zajon is kihoztunk 69,5 százalékos pontosságot, pedig az elvárt érték 50. Futtatható példákkal és ellenőrzőlistával.
Van egy adathalmazom. Száz sor, ötszáz oszlop, és minden egyes szám véletlen. A célváltozó is véletlen érmefeldobás. Ebben az adatban semmilyen összefüggés nincs, tehát bármilyen modell legfeljebb 50 százalékos pontosságot érhet el.
Lefuttattam rajta egy teljesen szokványos kiértékelést, és 69,5 százalékot kaptam.
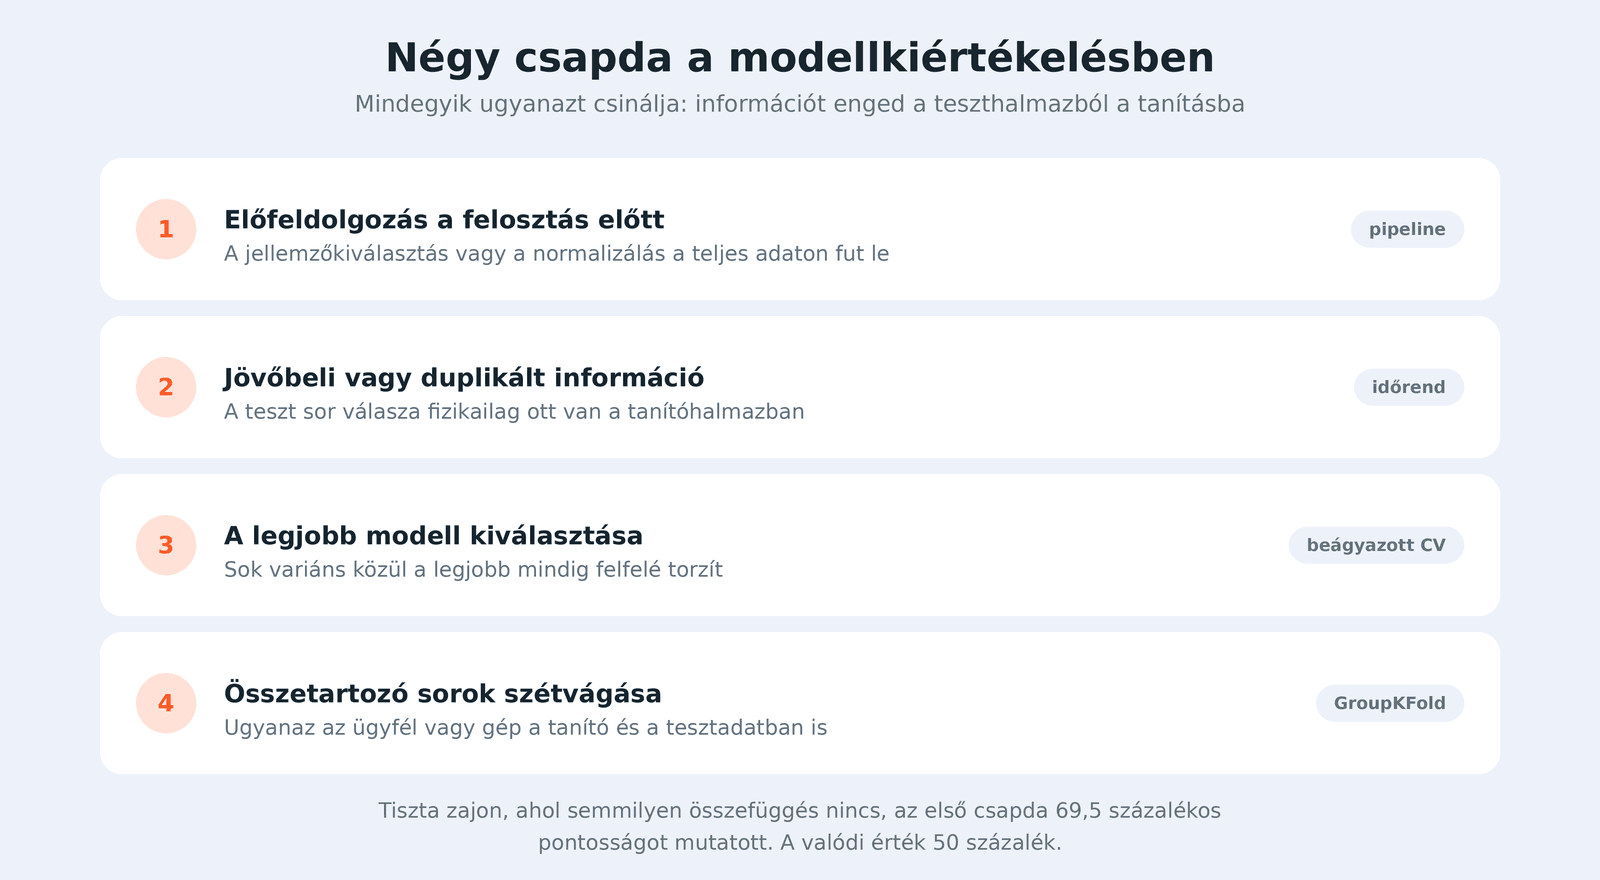
Ha egy prediktív modell irreálisan jó pontosságot mutat, az szinte soha nem a modell érdeme, hanem a kiértékelés hibája. Négy hiba okozza az esetek túlnyomó részét: előfeldolgozás a felosztás előtt, jövőbeli vagy duplikált információ a tanítóhalmazban, a legjobb modell kiválasztásának torzítása, és az összetartozó sorok szétvágása. Mindegyik ugyanúgy néz ki: a teszthalmazról szivárog információ a tanításba.
Azóta eltelt tizenhat év, és a probléma nemhogy nem tűnt el: 2023-ban egy princetoni kutatás 17 tudományterület 329 publikációjában találta meg ugyanezt, és nyolc különböző szivárgástípusból állított fel taxonómiát. Ez a poszt a négy legfontosabbat járja végig, futtatható példákkal.
Mennyire pontos valójában a modelled?
A kérdés megválaszolására a legelterjedtebb eszköz a k-szoros keresztvalidáció. Az adathalmazt k nagyjából egyenlő részre osztjuk, majd k-szor tanítunk: mindig k-1 részen, és a kimaradó részen mérünk. A k mérések átlaga a becslés. Ha k egyenlő a sorok számával, az a leave-one-out változat.
A módszer logikája azon áll, hogy a teszthalmaz a tanítás szempontjából érintetlen. Ha ez a feltétel bármilyen módon sérül, a becslés felfelé torzul, és nem kicsit. Innentől nem a modell teljesítményét mérjük, hanem azt, hogy mennyi információ szivárgott át.
A keresztvalidáció a CRISP-DM kiértékelési fázisának a technikai magja, és ez az a pont, ahol egy projekt csendben félrecsúszhat úgy, hogy hónapokig senki nem veszi észre.
1. csapda: előfeldolgozás a felosztás előtt
Ez a leggyakoribb és a legnehezebben észrevehető hiba.
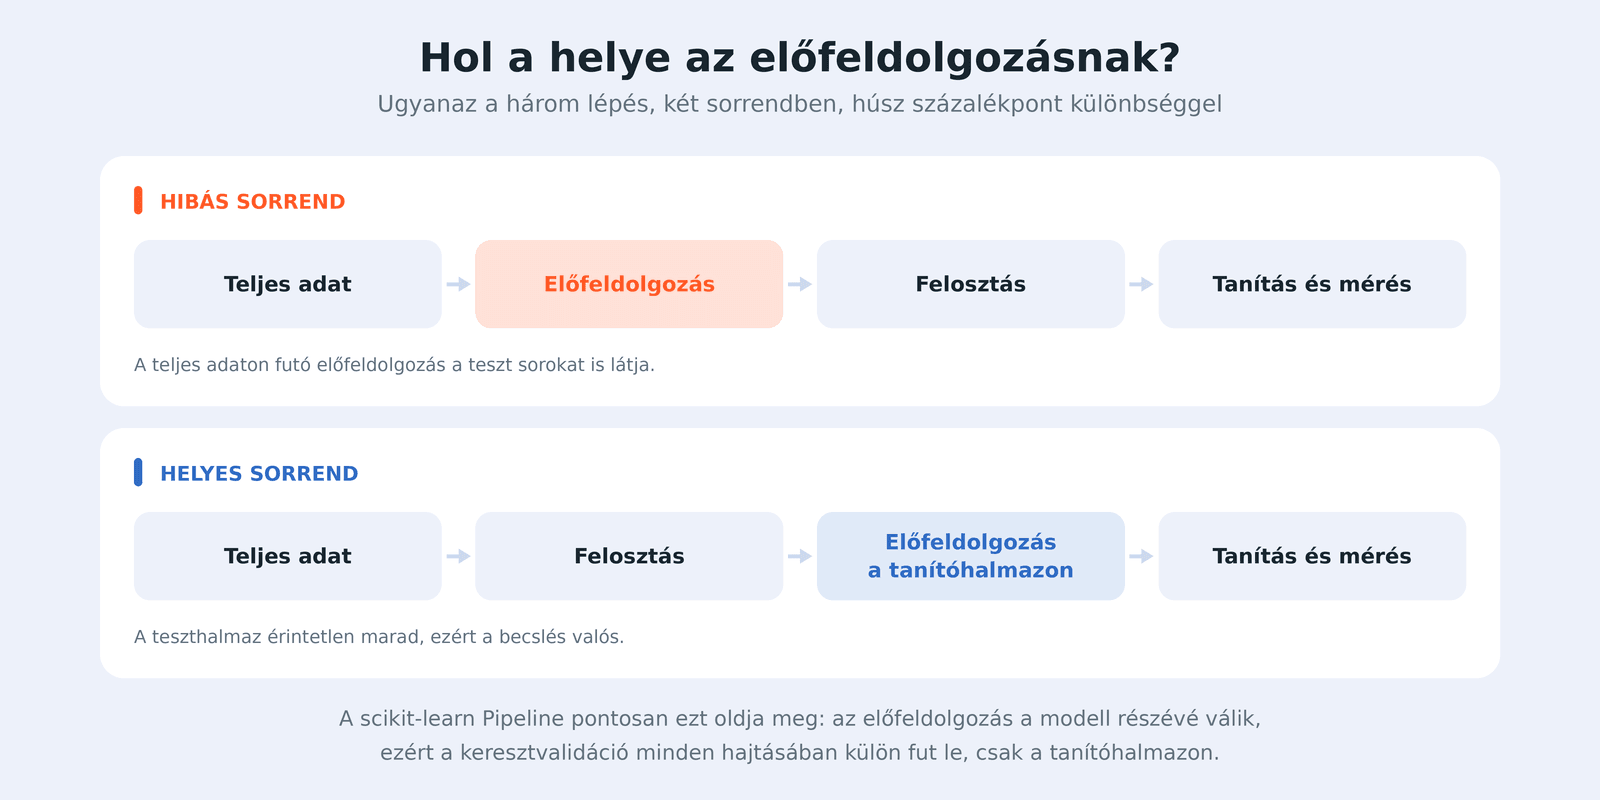
A jellemzőkiválasztás, a normalizálás, a hiányzó értékek pótlása mind előfeldolgozási lépés. Ha ezeket a teljes adathalmazon futtatod le, és csak utána jön a keresztvalidáció, akkor a kiválasztott jellemzők már tartalmaznak információt a teszthalmazról is. A modell nem látta a teszt sorokat, de a jellemzők, amikkel dolgozik, már igen.
A legdurvább eset a célváltozót használó jellemzőkiválasztás: kiválasztod azt az ötszázból tíz oszlopot, amelyik a legjobban korrelál a célváltozóval, aztán keresztvalidálsz. Csakhogy a korrelációt a teljes adaton nézted, tehát a teszt sorok célváltozói is beleszóltak abba, melyik oszlop maradt.
Mit hoz ez ki tiszta zajon?
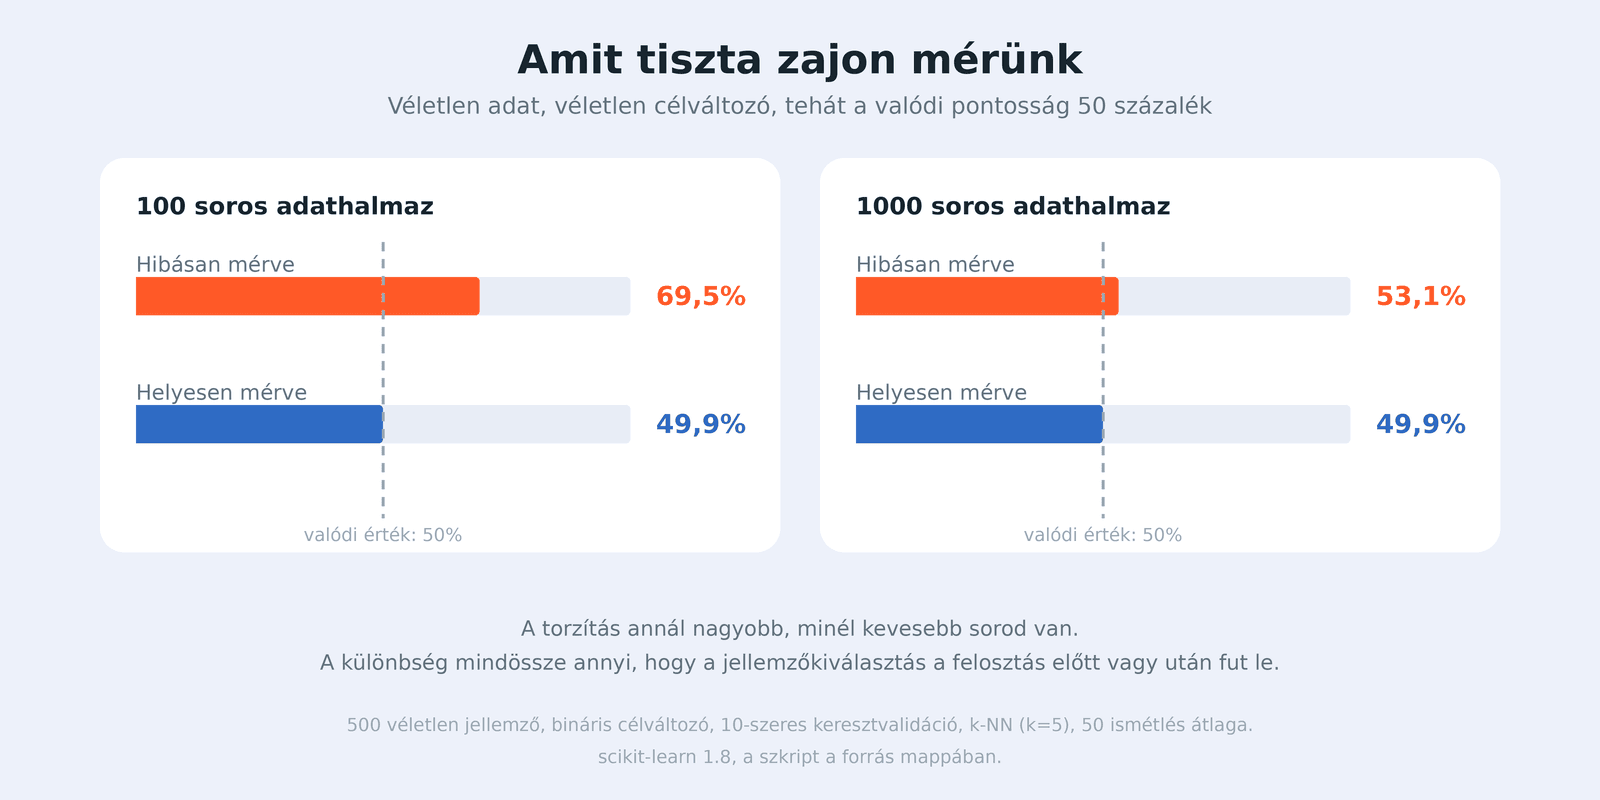
Lefuttattuk. Ötszáz véletlen oszlop, véletlen bináris célváltozó, ötven ismétlés átlaga, tízszeres keresztvalidáció, öt szomszédos k-NN osztályozó:
Sorok száma
Hibásan mérve
Helyesen mérve
Valódi érték
100
69,5%
49,9%
50%
1000
53,1%
49,9%
50%
Száz soron majdnem hetven százalékot mutat egy olyan adathalmaz, amiben semmi nincs. Ha ilyen eredményt kapnál egy valódi projektben, örülnél neki.
Két dolog látszik a táblázatból. Az egyik, hogy a torzítás mértéke az adat méretétől függ: minél kevesebb sorod van, annál nagyobbat téved a becslés. A másik, hogy a helyes kiértékelés pontosan azt adja, amit kell, vagyis ötven százalékot.
Hogyan kerüld el?
Két gyakorlati szabály:
Kérdezd meg magadtól: megcsinálható lenne ez a lépés a célváltozó ismerete nélkül? Ha nem, akkor a lépésnek a felosztás után, a tanítóhalmazon a helye.
Az előfeldolgozás legyen a modell része, ne az adaté. A scikit-learnben ez a Pipeline, és ez a legegyszerűbb védelem a hiba ellen.
A két hívás között annyi a különbség, hogy hol történik a kiválasztás. A mért pontosságban ez a különbség húsz százalékpont volt.
2. csapda: jövőbeli információ és duplikált sorok
Ez a hiba két külön formában jelenik meg, de a gyökere ugyanaz: a teszt sor válasza fizikailag benne van a tanítóhalmazban.
Duplikált sorok
Duplikátum a legváratlanabb helyekről kerül az adatba: elrontott SQL-join, kétszer lefuttatott betöltés, összefésült exportok. Ha egy sor kétszer szerepel, és a keresztvalidáció az egyik példányát teszteli, a másik ott van a tanítóhalmazban a helyes válasszal együtt.
Megmértük ezt is, megint tiszta zajon, egy szomszédos k-NN-nel:
Adathalmaz
Mért pontosság
Eredeti, 300 sor
49,6%
Ugyanaz, minden sor duplázva
95,0%
Semmi nem változott az adat információtartalmában. Csak minden sor kétszer szerepel.
Idősorok
Idősornál akkor keletkezik a hiba, amikor a sorozatot táblázatos formába alakítod (az elmúlt L érték jelzi előre a következőt), majd véletlenszerű felosztással keresztvalidálsz. A véletlen felosztás azt jelenti, hogy a modell a jövőből tanulhat a múltra, és ráadásul az egymást átfedő ablakok miatt a szomszédos sorokban ott a keresett érték.
Ennek a gyakorlati következménye az, hogy a modell interpolálni tanul meg, nem extrapolálni. Éles környezetben viszont mindig extrapolálnia kell, mert a jövő az, ami nincs még meg.
Lefuttattuk egy trendet és szezonalitást tartalmazó sorozaton, ötszörös keresztvalidációval:
Felosztás
Átlagos abszolút hiba
Véletlen KFold
0,83
Időrendet tartó TimeSeriesSplit
3,64
Négy és félszeres különbség. Ha a véletlen felosztás számával mennél az ügyfélhez, nagyon kellemetlen meglepetés érné a bevezetéskor. Ez a hiba különösen drága ott, ahol a becslés közvetlenül pénzbe kerül, például energiafogyasztás-előrejelzésnél, ahol a menetrendi eltérést azonnal ki kell fizetni.
Hogyan kerüld el?
Futtass duplikátumvizsgálatot minden betöltés után, ne csak egyszer a projekt elején.
Kérdezd meg: valóban független megfigyelés minden sor? Ha nem, a felosztásnak ezt tiszteletben kell tartania.
Idősornál mindig időrendet tartó felosztást használj (TimeSeriesSplit vagy kézi vágás egy dátum mentén).
3. csapda: a legjobb modell kiválasztásának torzítása
Ez a legalattomosabb a négy közül, mert pontosan akkor keletkezik, amikor jól dolgozol.
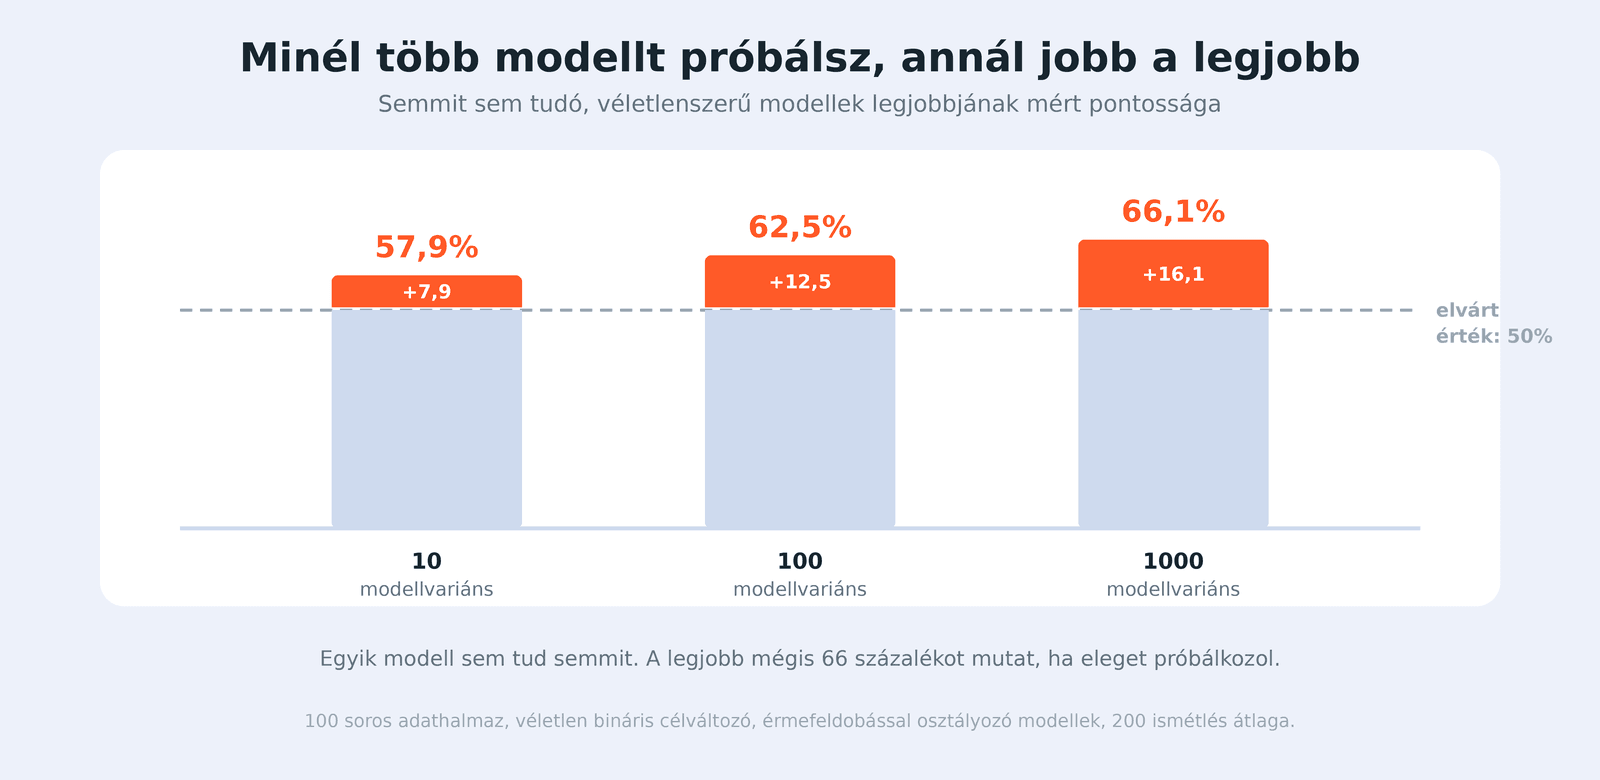
Képzelj el száz „érmemodellt", amelyek mindegyike érmefeldobással osztályoz. Mindegyik elvárt pontossága ötven százalék. Ha mind a százat lemérjük egy száz soros adathalmazon, és kiválasztjuk a legjobbat, akkor az a legjobb jóval ötven fölött lesz, pusztán a véletlen ingadozás miatt.
Lefuttattuk, kétszáz ismétlés átlagaként:
Hány modellt próbáltunk?
A legjobb mért pontossága
10
57,9%
100
62,5%
1000
66,1%
Egyetlen modell sem tud semmit. A legjobb mégis 66 százalékot mutat, ha eleget próbálkozol.
A gyakorlatban ez pontosan az, amit egy adattudós csinál: hiperparaméter-hangolás, több algoritmus kipróbálása, jellemzőkészletek variálása. Több száz vagy ezer kombináció fut le, és a legjobb kerül ki. Az a szám, amit a legjobb mutat, nem a teljesítmény becslése, hanem a maximuma, és a maximum mindig felfelé torzít. Minél kisebb az adathalmaz, annál jobban.
Beágyazott keresztvalidáció. A belső ciklus választja ki a legjobb modellt, a külső pedig független módon megméri, mennyit ér. A belső ciklus torzított száma nem kerül ki jelentésbe.
Külön félretett tesztadat. Egyszerűbb, de kisebb adathalmaznál pazarló, és csak egyszer szabad felhasználni. Ha kétszer nézel rá, már megint ugyanaz a hiba.
Ez a hiba akkor keletkezik, amikor egy entitáshoz több sor tartozik, de a felosztás soronként történik.
Tipikus esetek:
Ügyfelenként több tranzakció. Ha ugyanaz az ügyfél szerepel a tanító és a tesztadatban is, a modell megtanulhatja az ügyfelet, nem a viselkedést. Éles környezetben viszont új ügyfelekre kell működnie.
Gépenként több mérés. Ugyanaz a berendezés a tanító és a tesztadatban: a modell a gép egyedi jellemzőit tanulja meg.
Betegenként több felvétel az egészségügyi adatoknál. Ez a Kapoor és Narayanan tanulmány egyik leggyakrabban megtalált esete.
A megoldás az, hogy a felosztás az entitás szintjén történjen, ne a soron:
A kérdés, amit fel kell tenni: az éles működésben látott-e már a modell ilyen entitást? Ha nem, akkor a kiértékelésben sem szabad látnia.
Hogyan teszteld éles környezetben?
Eddig a modell minőségéről volt szó. Van azonban egy másik tesztelési kérdés, amit érdemes külön kezelni, mert más a célja.
Modellminőség tesztelése
Szoftvervalidáció
Mit vizsgálsz?
Mennyire jól teljesít a megoldás
Azt csinálja-e a kód, amit a matematikai leírás mond
Mi számít?
A gyakorlati eredmény
A specifikációnak való megfelelés
Mikor kell?
Minden projektben
Ha új eljárást fejlesztesz
A kettő nem helyettesíti egymást. Ha meglévő eljárásokat alkalmazol, akkor lényegében mindegy, hogy a döntési fa egy szinttel mélyebbre megy-e a tervezettnél, amíg jól teljesít független teszthalmazon. Ha viszont saját algoritmust implementálsz, akkor a jó eredmény nem bizonyíték: attól még lehet hibás a kód, csak éppen szerencsésen.
Saját implementáció validálására bevált technikák: kézzel is kiszámolható, apró adathalmazok; a paraméterek olyan beállítása, hogy az eljárás egy ismert algoritmussal legyen egyenértékű, majd a kimenetek összevetése; erős minta elrejtése az adatban, és annak ellenőrzése, hogy a módszer megtalálja-e; végül a lépésenkénti naplóelemzés. Tökéletes garanciát egyik sem ad.
Ami a bevezetés után jön
A kiértékelés nem ér véget az átadással. Két dolgot érdemes folyamatosan figyelni:
Adateltolódás. A bemeneti adatok eloszlása elmozdul attól, amin a modell tanult. Ez nem hiba, hanem a világ természete, csak észre kell venni.
Teljesítményromlás. Ha van visszacsatolás (kiderül utólag, mi lett a tényleges kimenet), akkor a modell pontossága rendszeresen újramérhető. Ha nincs, akkor közvetett mutatókat kell figyelni.
Mielőtt bármilyen pontosságszámot kiadsz a kezedből:
Minden előfeldolgozási lépés a pipeline része, nem az adat előkészítésének része?
Lefutott a duplikátumvizsgálat az aktuális adaton?
Idősornál időrendet tartó a felosztás?
Van-e olyan entitás (ügyfél, gép, beteg), amelyik egyszerre van a tanító és a tesztadatban?
Hány modellvariánst próbáltál ki, és a jelentett szám a külső, független mérésből származik?
A jellemzők között van-e olyan, ami az éles működésben a döntés pillanatában még nem lenne ismert?
Megegyezik-e a kiértékelési metrika azzal, ami üzletileg számít?
A hatodik pont a leggyakoribb üzleti változata az első csapdának: egy olyan mező kerül a modellbe, amit valójában csak az esemény után töltenek ki. A modell ilyenkor a jövőt látja, és a bevezetéskor derül ki, hogy a valóságban ez az adat még nincs meg.
Gyakori kérdések
Mi az adatszivárgás (data leakage)?
Az, amikor a modell olyan információhoz jut a tanítás során, ami az éles működésben a döntés pillanatában nem állna rendelkezésre. Leggyakrabban a teszthalmazból szivárog át információ az előfeldolgozáson keresztül, de idesorolható az is, ha egy jellemzőt valójában csak az előre jelzett esemény után töltenek ki.
Miért mutat a modellem irreálisan jó pontosságot?
A négy leggyakoribb ok: az előfeldolgozás a felosztás előtt futott le, duplikált vagy jövőbeli információ van a tanítóhalmazban, sok modellvariáns közül a legjobbat választottad ki ugyanazon az adaton, vagy összetartozó sorok kerültek a tanító és a tesztadatba egyszerre. Mind a négy ugyanazt jelenti: a teszthalmaz nem volt érintetlen.
Mire jó a scikit-learn Pipeline a kiértékelésben?
Arra, hogy az előfeldolgozás a modell részévé váljon, és így a keresztvalidáció minden hajtásában külön fusson le, csak a tanítóhalmazon. Ez a legegyszerűbb és leghatékonyabb védelem a leggyakoribb szivárgás ellen.
Hogyan kell idősort keresztvalidálni?
Időrendet tartó felosztással: mindig a múlton tanítunk és a jövőn mérünk. A scikit-learnben erre való a TimeSeriesSplit, de egy dátum mentén történő kézi vágás is megteszi. A véletlenszerű felosztás idősoron interpolációt mér, miközben az éles működésben extrapolálni kell.
Mi a beágyazott keresztvalidáció, és mikor kell?
Két egymásba ágyazott ciklus: a belső választja ki a legjobb modellt vagy hiperparamétereket, a külső pedig független módon megméri a kiválasztott modell teljesítményét. Akkor kell, amikor több modellvariánst hasonlítasz össze, tehát gyakorlatilag mindig. A belső ciklus legjobb pontszáma nem jelenthető eredményként.
Mennyire torzít a modellválasztás?
Annál jobban, minél több variánst próbálsz és minél kisebb az adathalmaz. A mérésünkben, teljesen véletlenszerű, semmit sem tudó modellekkel és száz soros adaton, tíz variánsból a legjobb 57,9, százból 62,5, ezerből 66,1 százalékot mutatott, miközben a valódi érték minden esetben 50 százalék.
Elég egyszer félretenni egy teszthalmazt?
Elég, ha tényleg csak egyszer nézel rá. A gyakorlatban ez ritkán teljesül: ha a teszthalmaz eredménye alapján módosítasz a modellen, majd újra megméred, akkor a teszthalmaz a modellválasztás részévé vált, és ugyanaz a torzítás keletkezik.
Következő lépés
Ha van futó vagy készülő modelletek, és a fenti hét kérdés közül bármelyikre nem egyértelmű a válasz, azt érdemes megnézni, mielőtt a modell használatba kerül. Egy átnézés általában néhány nap, és a leggyakoribb eredménye az, hogy a modell jó, csak a mért szám nem az, amit gondoltunk.
A CRISP-DM hat fázisa nem elmélet, hanem az a sorrend, amiben egy adatprojekt nem szalad félre. Végigvisszük egy banki hitelkártya-kampányon, megmutatjuk, hová megy el az idő, és hogy mi változott a bevezetés fázisában az MLOps korában.
Leíró, diagnosztikus, prediktív vagy preskriptív: négy projekttípus, négy különböző üzleti kérdésre. Táblázattal és valós projektpéldákkal ahhoz, hogy eldöntsd, a céged melyikkel induljon.
Az adatprojektek nem a technológián buknak el, hanem emberi és szervezeti okokon. A hét leggyakoribb buktató, a hetedik sikerkritérium, amiről ritkán esik szó, és az a három lépés, amivel a kockázat a töredékére csökkenthető.