A CRISP-DM hat fázisa nem elmélet, hanem az a sorrend, amiben egy adatprojekt nem szalad félre. Végigvisszük egy banki hitelkártya-kampányon, megmutatjuk, hová megy el az idő, és hogy mi változott a bevezetés fázisában az MLOps korában.
A CRISP-DM (Cross Industry Standard Process for Data Mining) egy iparágfüggetlen folyamatmodell adatelemzési projektekhez, amely hat fázisra bontja a munkát az üzleti cél megértésétől a kész megoldás üzemeltetéséig. A lényege nem a fázisok száma, hanem az, hogy a sikert üzleti oldalról definiálja, és közös nyelvet ad az üzleti döntéshozónak és az adatelemzőnek.
Ez a cikk végigviszi a hat fázist egy valós banki példán, és megmutatja, hol szokott félrecsúszni egy projekt. Ha az a kérdés, milyen típusú projektbe érdemes belevágni, arról a data science projektek négy típusa szól.
A cikk 2019-ben jelent meg, azóta frissítettük, elsősorban a bevezetési fázist és az új típusú, nyelvi modellekre épülő projektek kérdését.
Mi a CRISP-DM, és honnan jött?
1996-ban három cég, a DaimlerChrysler, az SPSS és az NCR abból indult ki, hogy túl sok adatelemzési projekt bukik meg. Összegyűjtötték, mi jellemzi a sikeres projekteket, két és fél éven át finomították és tesztelték a gyakorlatban, és ebből lett 1999-re a CRISP-DM 1.0.
A módszertannak négy célja volt, és ezek ma is érvényesek: tegye érthetővé az adatelemzési projektet annak is, aki most találkozik vele, tegye megismételhetővé a folyamatot, adjon iránymutatást arról, mi a projekt kimenete, és adjon közös nyelvet az üzletnek és az elemzőnek.
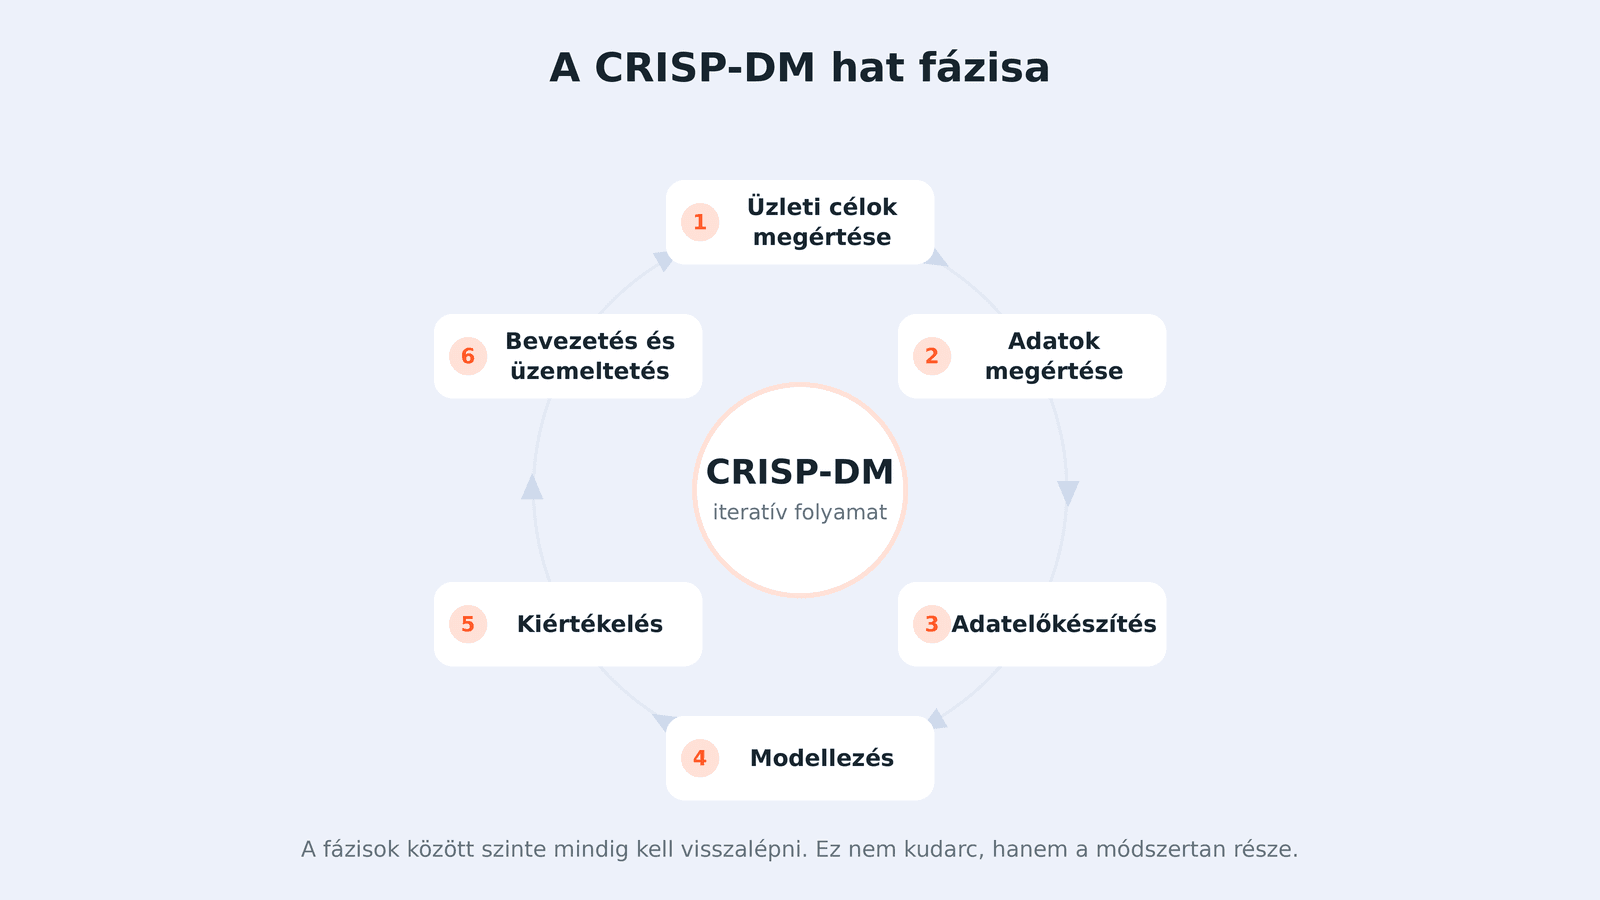
A módszertan három szinten épül fel. A legfelső szinten van a hat fázis, alatta az általános, bármely projektre érvényes feladatok, legalul pedig az adott projektre szabott konkrét tennivalók. A gyakorlatban a legfelső két szintet érdemes fejben tartani, a harmadikat minden projekt maga írja meg.
A hat fázis egy táblázatban
#
Fázis
Mire válaszol
Mi a kimenete
Tipikus ráfordítás
1
Üzleti célok megértése
Mi a probléma, és mikor mondjuk sikeresnek?
Üzleti cél, sikerkritérium, adatelemzési feladat
Kicsi, de meghatározó
2
Adatok megértése
Milyen adat van, és mit jelent üzletileg?
Adatleírás, adatgazdák, első anomáliák
Közepes
3
Adatelőkészítés
Hogyan lesz az adatból elemezhető tábla?
Elemzési adattábla, új változók
A legnagyobb
4
Modellezés
Melyik algoritmus mit tud ezen az adaton?
Betanított modellek, összehasonlítás
Kicsi, 5-10 százalék
5
Kiértékelés
Teljesülnek-e az első fázis sikerkritériumai?
Üzleti döntés: megy vagy iterálunk
Kicsi
6
Bevezetés és üzemeltetés
Hogyan épül be a mindennapi működésbe?
Éles rendszer, monitorozás, felelősök
Folyamatos
A fázisok közötti sorrend nem egyirányú utca. Szinte minden projektben kell visszalépni az egyes fázisok között, jellemzően a kiértékelésből az adatelőkészítésbe, és ez nem kudarc, hanem a módszertan része.
1. Üzleti célok megértése
Ez a fázis négy kérdést válaszol meg. Mi az üzleti probléma? Mi az elérni kívánt üzleti cél? Hogyan mérjük számszerűen a sikert? És milyen adatelemzési feladattá fordítható mindez?
A feladatok: az üzleti célok áttekintése, helyzetértékelés (erőforrások, korlátok, feltételek), az üzleti cél lefordítása technológiai nyelvre, és a sikerkritériumok rögzítése.
A banki példa. Egy kereskedelmi bank hitelkártyát szeretne ajánlani a meglévő bankkártyás ügyfeleinek. Az ötlet az, hogy a bankkártyás tranzakciók elemzésével azonosítsuk azokat, akik a legnagyobb eséllyel fogadják el az ajánlatot. A bank futtatott már hasonló kampányt, tehát tudja, kik vették végül használatba a terméket. A cél: tízezer ügyfél megcélzásával elérni az ügyfélalap felét, a legígéretesebb jelöltekkel. Adatelemzési feladattá fordítva ez egy osztályozási feladat, amely az ügyfeleket az elfogadás valószínűsége szerint rangsorolja.
Az a mondat, hogy "tízezer ügyfél megcélzásával az ügyfélalap felét", többet ér, mint bármilyen technológiai specifikáció. Enélkül a projekt végén nem lehet megmondani, sikerült-e. Ez egyben az a pont, ahol az adatvezérelt döntéshozatal a gyakorlatban eldől: ha a sikerkritérium nincs előre leírva, utólag mindig lesz magyarázat.
2. Adatok megértése
Itt derül ki, milyen adat áll rendelkezésre, és főleg az, hogy üzletileg mit jelent. Feladatok: az elérhető adatok összegyűjtése, az adatgazdák megtalálása (ők tudják, mit jelent egy mező valójában), az adatforrások összekapcsolásának megtervezése, az időtávok és a közös kulcsok azonosítása. A fázis terméke egy részletes adatleírás.
A banki példa. Két adathalmaz van: a bankkártyás tranzakciók és az előző kampány eredménye. A kérdések: hogyan kapcsolható össze a kettő, milyen változók vannak és üzletileg mit jelentenek, vannak-e hiányzó értékek vagy anomáliák, és vannak-e kiugró értékek, például abnormálisan magas kereset vagy kártyahasználat.
Ha ez a fázis egy szervezetnél rendre elakad, az általában nem projektkérdés, hanem szervezeti: nem tudjuk, milyen adatvagyona van a szervezetnek. Erre való az adatvagyon-felmérés.
3. Adatelőkészítés
Ez a leghosszabb és a legkevésbé látványos fázis, és a projekt sorsa jellemzően itt dől el. Az a dolga, hogy az algoritmus számára hozzáférhetővé tegye azt az üzleti logikát, amit az magától nem lát.
Adatkiválasztás: mit használunk, mit hagyunk ki.
Adattisztítás: hiányzó és kiugró értékek kezelése, anomáliák azonosítása.
Adatgazdagítás: külső források bevonása, üzleti logikán alapuló új változók képzése.
Célváltozó: rendelkezésre áll, vagy elő kell állítani.
Adatintegráció: a források összekapcsolása, az elemzési adattábla létrehozása.
A banki példa. A tranzakciós adatban ügyfelenként sok sor van, a modellnek viszont ügyfelenként egy sor kell. Aggregálni kell: átlagos havi költés, hány napig elég a fizetése, a kiadások és a bevételek aránya. És van egy szabály, amit könnyű elrontani: ezeket az aggregációkat csak a kampány megkeresésének időpontjáig terjedő tranzakciókból szabad számolni, mert éles használatkor sem áll rendelkezésre a "jövő". Ha ez kicsúszik, a modell a teszten kiválóan teljesít, élesben pedig nem.
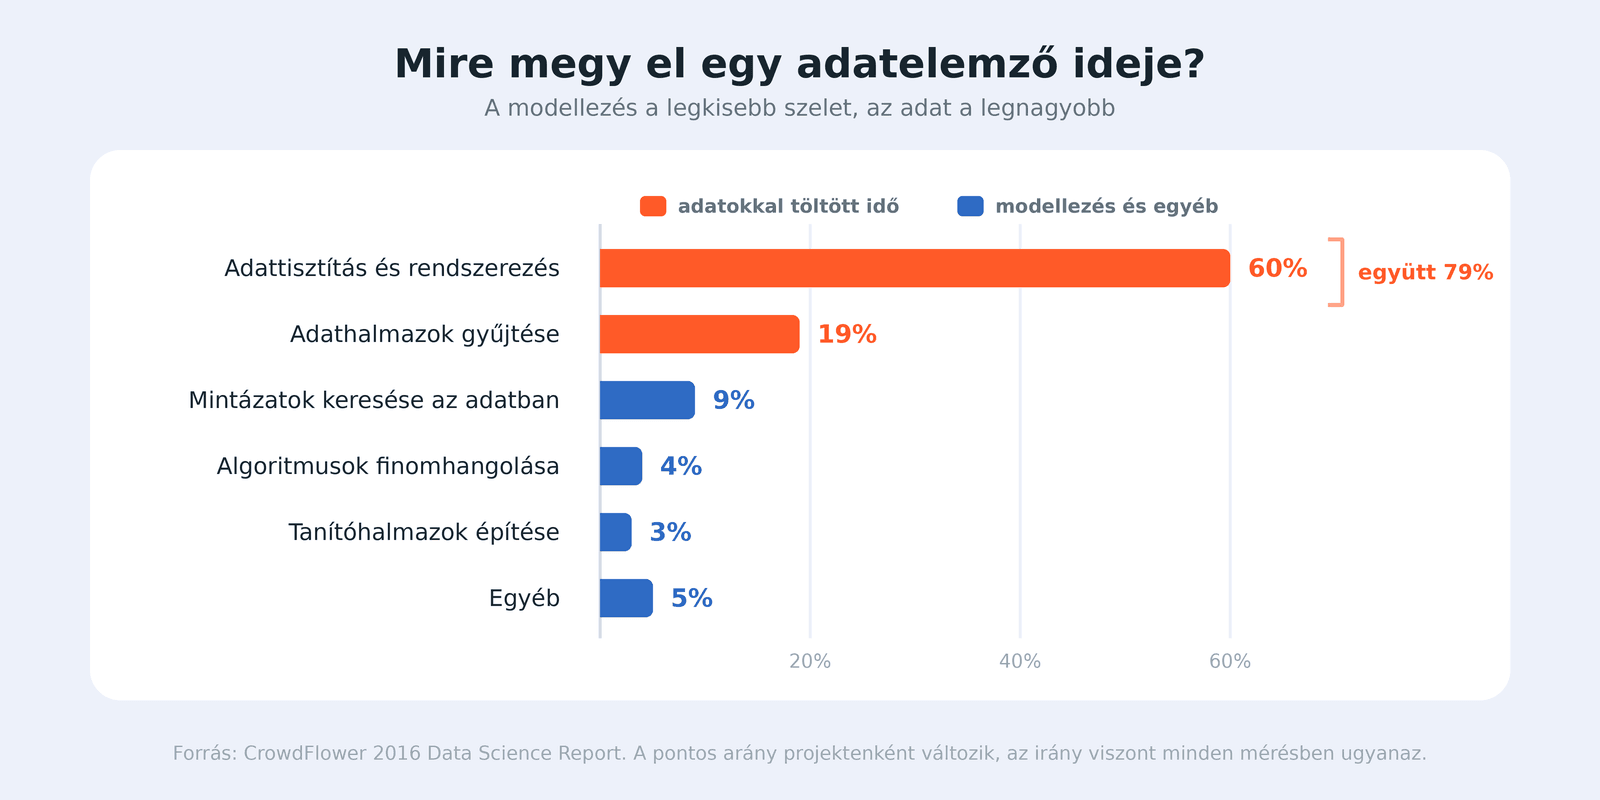
Mennyi idő ez valójában? A saját tapasztalatunk szerint egy adatprojekt sikere nagyjából 80 százalékban ezen a fázison múlik. Az iparági felmérések a ráfordított időről hasonló képet mutatnak: a CrowdFlower 2016-os adattudományi felmérése szerint az adatelemzők az idejük 60 százalékát adattisztítással és rendszerezéssel, további 19 százalékát adathalmazok gyűjtésével töltik. Tegyük hozzá, hogy ezt a számot azóta többen vitatják, és a pontos arány nyilván cégenként és projektenként változik. Az irány viszont minden mérésben ugyanaz: az idő nagy része nem a modellezés.
4. Modellezés
Erre a fázisra jellemzően a projekt erőforrásainak 5-10 százaléka jut, éppen azért, mert az előkészítés viszi el a java részt.
Feladatok: az algoritmusok kiválasztása az első fázisban rögzített feladat alapján, a tesztterv elkészítése (hogyan mérjük vissza múltbeli adaton a modellt), a modellek felépítése és a paraméterek kalibrálása, a kiértékelés, és a feltárt összefüggések értelmezése.
Három elv, ami sokat számít. Ne a véletlenhez mérjük a modellt, hanem egy baseline megoldáshoz. Több algoritmussal építsünk modellt, és hasonlítsuk össze őket. És az első körök tanulságaiból építsünk új változókat, mert a legtöbb javulás nem az algoritmusváltásból jön, hanem az adatból.
A banki példa. A baseline az a szabály, amit az üzleti csapat eddig kézzel alkalmazott. Ha a modell ezt nem veri meg, nincs miről beszélni. Ha megveri, akkor több algoritmus összevetése, és adott esetben kombinálása következik.
5. Kiértékelés
Ez a fázis nem a modell pontosságáról szól, hanem arról, hogy az első fázisban rögzített üzleti sikerkritérium teljesül-e. Feladatai: a modell teljesítményének értékelése az üzleti célhoz képest, annak eldöntése, hogy üzletileg használható-e, és szükség esetén visszalépés egy korábbi fázisba.
A banki példa. Ha a modell csak két hónapra előre jelzi jól az elfogadást, miközben az üzlet hat hónapos előrejelzésre számított, az még nem feltétlenül kudarc: lehet, hogy két hónapos horizonton is van értelmes kampány. De az elvárást ki kell mondani újra, nem elhallgatni.
Itt a leggyakoribb hiba nem az, hogy a modell rossz, hanem az, hogy jobbnak tűnik, mint amilyen. A tipikus modellkiértékelési hibák szinte mind ebben a fázisban derülnek ki, vagy éppen itt maradnak észrevétlenül.
6. Bevezetés és üzemeltetés
A modell akkor ér valamit, ha beépül a működésbe. Feladatok: bevezetési terv, az érintett folyamatok azonosítása, a szereplők feladatainak módosítása, valamint a monitorozás és karbantartás megtervezése.
Mérés éles környezetben. A banki példánál az AB teszt adja a tiszta mérést: az A csoport a modell által kiválasztott ügyfelekből áll, a B csoport véletlenszerű kontroll. A modell akkor bizonyított, ha az A csoportban lényegesen magasabb a hitelkártya-használat. Enélkül nem lehet elkülöníteni a modell hatását attól, hogy a kampány önmagában is működött volna.
Minden modellnek lejár a szavatossága. Ez a fázis legfontosabb mondata. A piac változik, az ügyfelek viselkedése változik, az adat szerkezete is változik. Ezért kell hozzá monitorozás: figyelni a bemeneti adatok eloszlásának elmozdulását, a modell teljesítményének romlását, és előre eldönteni, milyen romlásnál tanítjuk újra.
Ezt a részt ma MLOps néven szokták emlegetni: verziózott modellek és adatok, automatizált újratanítás és kiszállítás, riasztások. A név új, a feladat nem. Amihez a módszertan eredetileg nem adott támpontot, az a magyarázhatóság: ha a modell döntését meg kell tudni indokolni az ügyfélnek vagy a felügyeletnek, akkor az a magyarázható mesterséges intelligencia eszköztárából jön, és már a negyedik fázisban meg kell tervezni.
Hogyan alkalmazzuk a Dmlabnál?
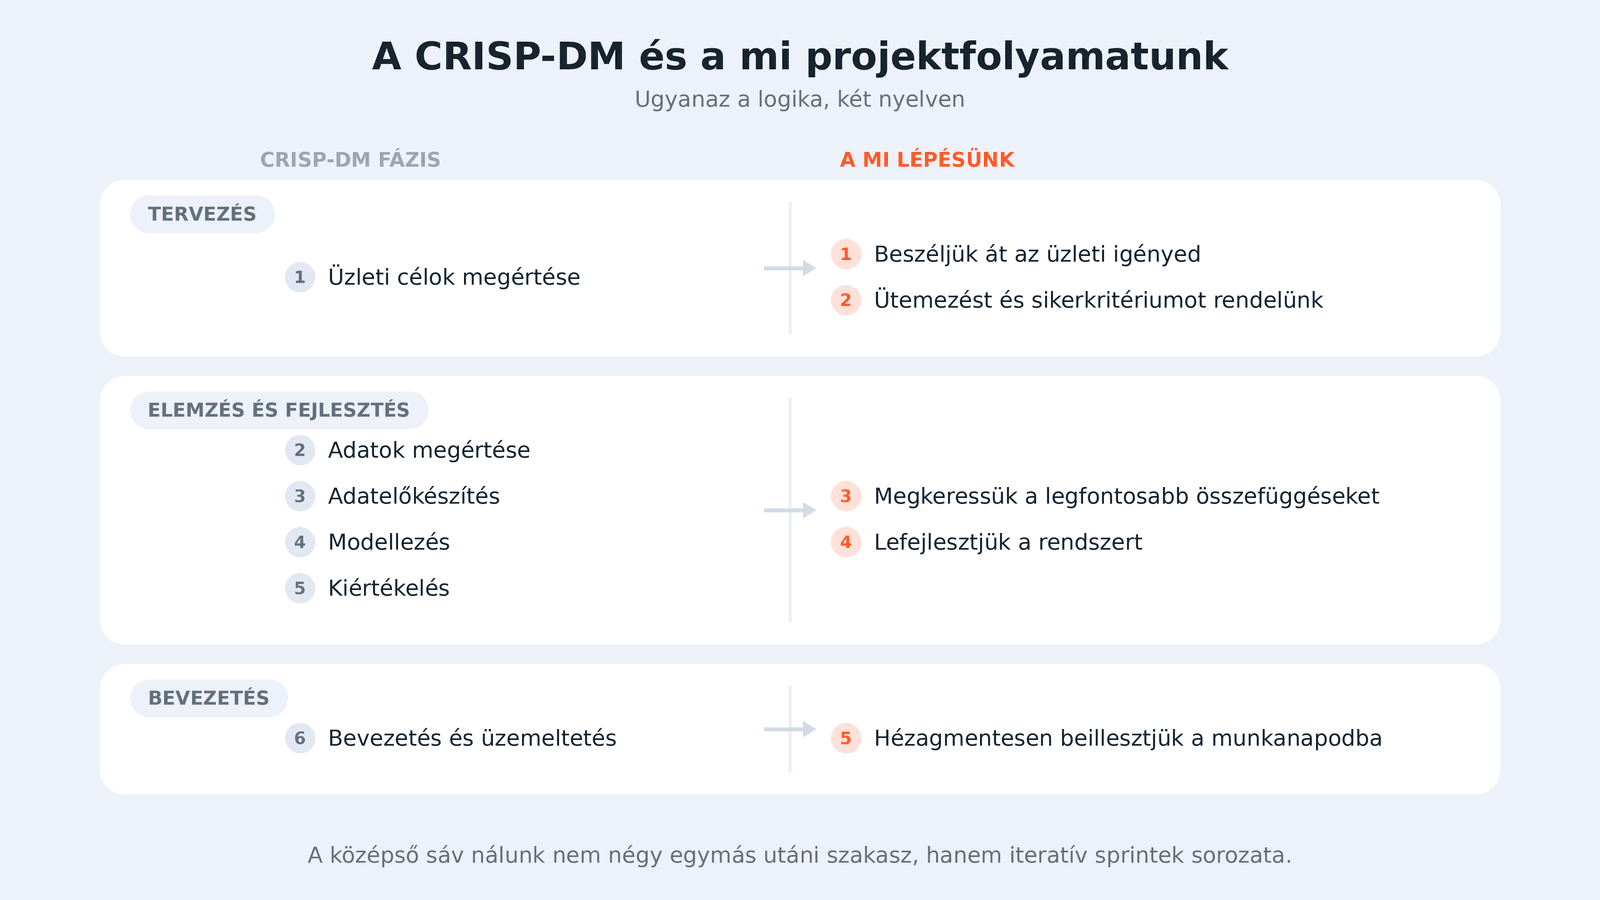
A saját projektfolyamatunk öt lépésből áll, és ezek a CRISP-DM hat fázisára képezhetők le.
Szakasz
CRISP-DM fázis
A mi lépésünk
Tervezés
1. Üzleti célok megértése
Beszéljük át az üzleti igényed. Ütemezést és sikerkritériumot rendelünk hozzá, objektív KPI-okhoz kötve
Elemzés és fejlesztés
2-5. Adatok megértése, előkészítés, modellezés, kiértékelés
Megkeressük a legfontosabb összefüggéseket iteratív elemzési sprintekben. Lefejlesztjük a rendszert, prototípussal és teszteléssel
Bevezetés
6. Bevezetés és üzemeltetés
Hézagmentesen beillesztjük a munkanapodba, bevezetéssel és karbantartással
A leglényegesebb pont a második sor. A CRISP-DM négy fázisa nálunk nem négy egymás utáni szakasz, hanem iteratív sprintek sorozata, ahol minden megbeszélésen látszik valami új. Ez az, ami a módszertant agilis működésbe illeszti.
CRISP-DM és az agilis működés
A CRISP-DM nem vízesésmodell, még ha a szokásos ábrája miatt annak tűnhet is. A fázisok között szinte mindig kell iterálni, és ez az iteráció pontosan úgy viselkedik, mint egy sprint: van egy kérdés, egy időkeret, és a végén egy megmutatható eredmény.
A gyakorlati különbség a szoftverfejlesztési sprinthez képest az, hogy egy adatos sprint kimenete nem mindig funkció. Néha az a kimenet, hogy egy irány nem járható, és ez ugyanolyan értékes, ha gyorsan derül ki. Ezért érdemes a korai sprinteket a legnagyobb bizonytalanságra tervezni, nem a legkönnyebb feladatra.
Működik ez nyelvi modellekre épülő projekteknél is?
Igen, a hat fázis szerkezete változatlan, két fázis tartalma viszont más.
A harmadik fázisban az adatelőkészítés helyét részben a kontextus előkészítése veszi át: milyen dokumentumokból dolgozik a rendszer, hogyan darabolódnak, mi kerül be a keresésbe. Ez éppúgy a projekt legnagyobb munkája, mint klasszikus esetben az adattábla összerakása.
A negyedik fázisban ritkábban tanítunk saját modellt, inkább egy meglévőt illesztünk a feladathoz. Cserébe az ötödik fázis lesz nehezebb: nincs egyetlen pontossági szám, a kiértékeléshez saját tesztkészletet és értékelési szempontokat kell építeni.
Ami nem változik: az első fázis. Egy nyelvi modellre épülő projekt is akkor fut zátonyra, ha nincs kimondva, mi a siker.
Gyakori kérdések
Mit jelent a CRISP-DM rövidítés?
Cross Industry Standard Process for Data Mining, vagyis keresztiparági szabványos folyamat az adatbányászathoz. 1996-ban indult a fejlesztése, és 1999-re készült el az első változata.
Melyik fázis viszi el a legtöbb időt?
Az adatelőkészítés. Az iparági felmérések szerint az adatelemzők idejének nagyjából kétharmada tisztítással és rendszerezéssel telik, a modellezésre pedig jellemzően a projekt erőforrásainak 5-10 százaléka jut.
Vízesésmodell a CRISP-DM?
Nem. A fázisok sorrendje adott, de a visszalépés a módszertan része, és a gyakorlatban szinte minden projektben szükség van rá. Iteratív sprintekkel jól összeegyeztethető.
Mi a különbség a CRISP-DM és a TDSP vagy a SEMMA között?
Mindegyik ugyanazt a problémát oldja meg, de más hangsúllyal. A CRISP-DM a legelterjedtebb, mert gyártófüggetlen, és az üzleti oldalról indul, nem az adatbányászati eszközből.
Használható-e kisebb, néhány hetes projektre is?
Igen, sőt ott a legfontosabb az első fázis. Egy rövid projektnél nincs idő menet közben kitalálni, mit jelent a siker.
Beszéljük át a projektedet
Ha van egy adatos ötlet, amiről nem világos, hogyan lehetne belőle projekt, az első lépés általában nem a technológia, hanem az, hogy kimondjuk, mikor mondanánk sikeresnek.
Leíró, diagnosztikus, prediktív vagy preskriptív: négy projekttípus, négy különböző üzleti kérdésre. Táblázattal és valós projektpéldákkal ahhoz, hogy eldöntsd, a céged melyikkel induljon.
Az adat nem az új olaj, hanem az új gyarmati nyersanyag: az a kérdés, ki dolgozza fel és ki adja el a belőle készült terméket. Pazarlók, gyűjtögetők és adatvezéreltek, a tárolási dilemma GDPR után, és az az eset, amikor nem üzleti kérdésből, hanem magából az adatból indulunk ki.
Az adat megvan, a döntés mégis ösztönből születik. Kahneman gyors és lassú gondolkodása, a három torzítás, ami a tárgyalóban a legtöbbet árt, és az a néhány lépés, amivel a tudatos rendszernek adunk esélyt.